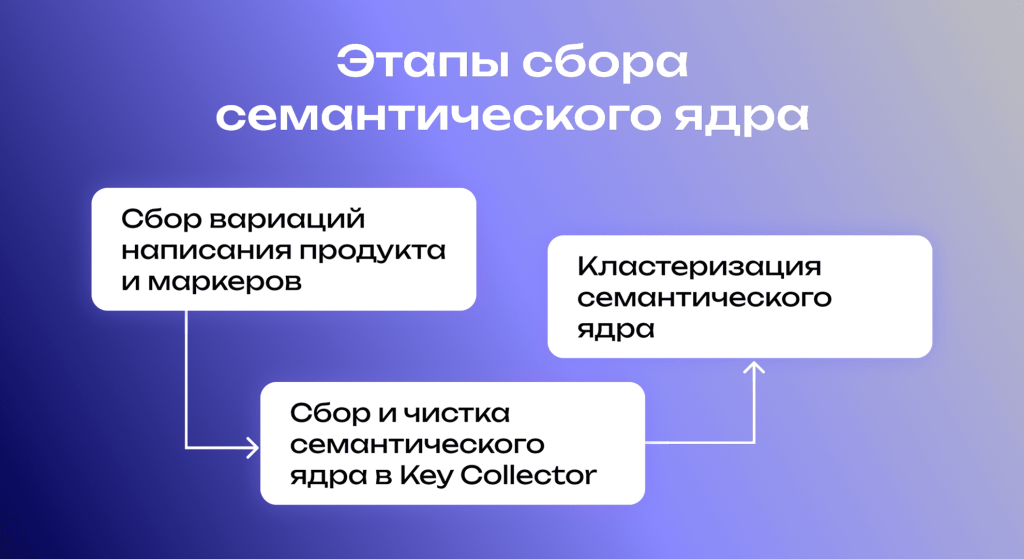
Семантическое ядро — это список поисковых запросов, разложенный по страницам сайта: какой запрос ведет на какую страницу.
Как собрать семантическое ядро:
- Выписать, как называют то, что продает сайт, то есть товар или услугу, и какие у него свойства; из этого получается короткий список фраз.
- Расширить список формулировками из Вордстата и получить по каждой частотность, то есть число запросов в месяц.
- Убрать лишнее.
- Сгруппировать запросы: в одну группу идут те, по которым поиск показывает одни и те же страницы.
- Разложить группы по страницам.
Например, у дилерского центра запрос «лада веста купить» ведет на карточку модели, а «замена масла лада веста» открывает страницу сервиса. Готовое ядро становится планом сайта: у каждой группы запросов есть своя страница, а группы без страницы показывают, чего на сайте не хватает.
Порядок сбора семантического ядра
| Этап | Что на входе | Что на выходе | Чем делают |
1. Маркерные запросы и маркеры |
Структура сайта, страницы конкурентов из топ-10 |
20–200 коротких фраз вида «лада веста купить» |
Вордстат, фильтры на сайтах конкурентов |
2. Расширение списка и сбор частотности |
Маркерные запросы |
Несколько тысяч формулировок, у каждой базовая и точная частотность |
Key Collector, Вордстат вручную, онлайн-сервисы |
3. Чистка семантического ядра |
Список с частотностью |
Только запросы, на которые сайт может ответить |
Стоп-слова, фильтры, ручной просмотр |
4. Кластеризация |
Очищенный список |
Группы запросов под отдельные страницы |
Сервисы кластеризации по выдаче |
5. Разбивка по страницам |
Кластеры |
Таблица «кластер — страница» |
Таблица и проверка релевантных страниц |
Пятый этап и превращает список в план: пока у групп нет адресов, структура сайта и тексты остаются прежними.
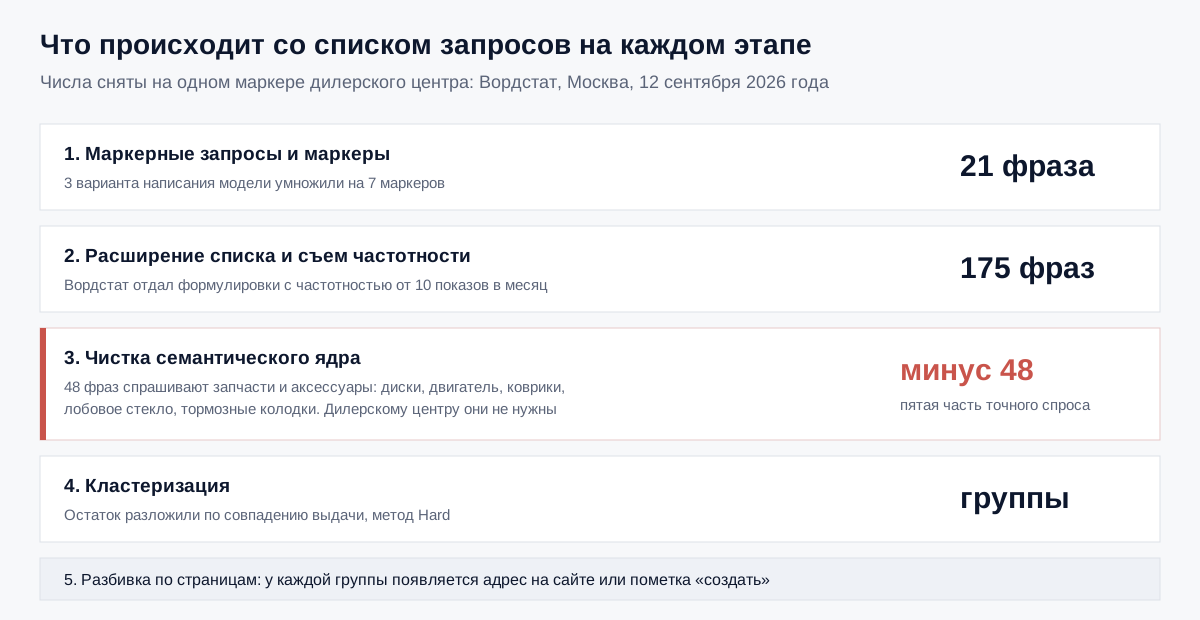 Список растет на расширении и сокращается на чистке. Числа сняты на одном маркере дилерского центра
Зачем нужно семантическое ядро
По ядру строят структуру разделов. Кластер — это группа запросов, которые ведут на одну страницу; кластер, у которого своей страницы нет, означает раздел, которого на сайте нет, и найти такие пробелы можно только после группировки. По ядру пишут тексты: у каждой страницы есть головной запрос, то есть самый частотный в кластере, и список запросов для разделов.
По ядру видно, какие страницы надо развести между собой. Два запроса, похожие по словам, иногда требуют двух разных страниц, а два непохожих продвигаются на одной. Ответ дает выдача: одна страница на два запроса, если у них в топ-10 стоят одни и те же адреса.
Каждому кластеру нужна страница. У работающего сайта часть страниц уже есть, и объем работы равен числу недостающих: его и закладывают в план и бюджет.
Собранное ядро отвечает и на вопрос, чего делать не нужно. Например, дилерский центр видит в собранном спросе запросы про ремонт своими силами: их много, а заявок они не дают.
Этап 1. Маркерные запросы и маркеры
Маркерный запрос — это фраза, с которой начинают сбор: «лада веста купить», «мрт головного мозга цена», «внедрение битрикс24 стоимость». Складывается она из названия предмета («лада веста», «мрт головного мозга») и уточнения: что человек хочет с предметом сделать или какой именно предмет ему нужен. Это уточнение называют маркером: «купить», «цена», «седан», «в кредит», «на юго-западе». Названия предмета умножают на маркеры, и получается список маркерных запросов, с которого начинается подбор ключевых слов.
Один предмет люди называют по-разному, и каждое написание образует отдельный спрос. Например, если бы предметом была сама статья про создание семантического ядра: «seo ядро» набирают 195 раз в месяц, «сео ядро» 159 раз, и это один вопрос в двух написаниях (Вордстат, 12 сентября 2026 года). Для Вордстата это два разных запроса, и расширять список надо по каждому: у пропущенного написания останутся несобранными свои длинные формулировки. На одну ли страницу они лягут, решится позже, на кластеризации.
Написания предмета и маркеры берут из трех источников, а у работающего сайта есть четвертый.
Вордстат. Сервис показывает статистику запросов к Яндексу [1]. В строку вводят название предмета, «лада веста», и открывают вкладку «Топы запросов»: там два списка за последний месяц, популярные запросы с этой фразой и похожие на нее запросы. Другие написания предмета стоят во втором списке, а маркеры вроде «купить», «цена», «в кредит» — в первом, рядом с названием. Чтобы выполнить запрос, нужно войти в Яндекс ID: без авторизации сервис показывает только описание. Правой колонки с похожими запросами, которую показывают старые инструкции, в сервисе больше нет; адрес old.wordstat.yandex.ru открывает тот же новый интерфейс (проверено 12 сентября 2026 года).
Свой сайт. Семантику сайта, который уже есть, начинают с него самого: берут названия категорий, брендов и услуг плюс значения фильтров. У дилерского центра названия предметов — это марки и модели, маркеры — типы кузова и коробка передач из фильтров каталога, а в сервисном разделе виды работ.
Яндекс Вебмастер. У работающего сайта есть готовые данные: раздел «Поисковые запросы» перечисляет фразы, по которым люди уже переходят из поиска. С них список маркерных запросов и начинают.
Конкуренты из топ-10. Смотрят на структуру разделов и на фильтры каталога: в фильтрах свойства уже сгруппированы, и группы видно сразу. Сайты для разбора находят по названию предмета: вводят «лада веста» в поиск и берут первую десятку, а если предметов много, их названия отдают инструменту «Поиск конкурентов» в engine.seointellect.ru [6].
Полученные варианты умножают на маркеры. В Excel названия предмета ставят в первый столбец, маркеры — в первую строку, а в каждую ячейку на пересечении пишут формулу =СЦЕП($A2;" ";B$1). Формулу растягивают на всю таблицу, и она выдает все сочетания разом: три названия на семь маркеров дают двадцать одну фразу. СЦЕП есть в Excel с версии 2016; в старых версиях та же формула пишется через СЦЕПИТЬ [2].
Пример: как подбирали запросы для дилерского центра Lada. Варианты написания модели: «лада веста», «lada vesta», «веста». Маркеры: «купить», «в кредит», «в наличии», «цена», «комплектации», «седан», «универсал». Умножение дает 21 фразу, и с них начинают сбор.
Этап 2. Расширение списка и сбор частотности
Расширение — это сбор реальных формулировок, которыми люди спрашивают то же самое. Список маркерных запросов загружают в Key Collector весь сразу и запускают сбор семантики: по каждому запросу программа забирает из Вордстата все формулировки, где он встречается, и на выходе получается несколько тысяч строк. Key Collector раскладывает фразы по папкам, если перед каждой стоит имя папки и двоеточие: Веста:лада веста купить. Имя дописывают той же функцией, =СЦЕП("Веста:";A2), по одной папке на предмет; дальше с папками работают порознь. Программа платная и работает только под Windows; на macOS этот этап проходят в онлайн-сервисах, о них в разделе «Чем собирать, кроме Key Collector».
Без программы то же делают вручную, и двоеточие тогда не нужно. На этапе 1 «Топы запросов» открывали по названию предмета ради написаний; здесь их открывают по каждому маркерному запросу и переносят в файл все формулировки вместе с числами. Для ядра до сотни итоговых запросов этого хватает; для большего ручной сбор занимает дни.
Масштаб виден на одном маркерном запросе. По фразе «лада веста купить» Вордстат отдает 175 формулировок с частотностью от 10 в месяц (Москва, 12 сентября 2026 года; фразы реже десяти раз в месяц отброшены при сборе: такой порог стоит в настройках Key Collector и других сборщиков). Страниц под все 175 формулировок у дилерского центра нет, и это нормальная картина на входе: разбираться, какие из них нужны, будут на чистке.
Вместе с каждым запросом из Вордстата приходит одно число, базовая частотность: она учитывает все фразы, где встречается запрос, вместе взятые. Для отбора этого мало, нужна еще точная частотность, и ее собирают отдельным прогоном, дописывая к запросу операторы.
| Как записан запрос | Что считает | Пример: «как собрать семантическое ядро» |
без операторов |
Базовая частотность: все запросы, где встречается фраза в любых формах и с любыми добавками |
330 |
|
Только эту фразу без добавок, но во всех словоформах |
— |
|
Точная частотность: только эта фраза в этой словоформе |
220 |
|
То же плюс фиксированный порядок слов |
— |
Числа в третьем столбце взяты из Вордстата: Москва, с компьютера, 12 сентября 2026 года. Кавычки в Вордстате обычные, прямые. Порядок слов без операторов не важен: «лада веста купить» и «купить лада веста» для базовой частотности одна фраза. Две записи без чисел для примера не собирали: в работе хватает базовой и точной, запись в кавычках и запись со скобками нужны редко. Точная запись для «как собрать семантическое ядро» выглядит так: "!как !собрать !семантическое !ядро".
Отношение точной частотности к базовой мы называем коэффициентом эффективности запроса: точная × 100 / базовая. Он показывает, какая доля базового числа приходится на саму фразу.
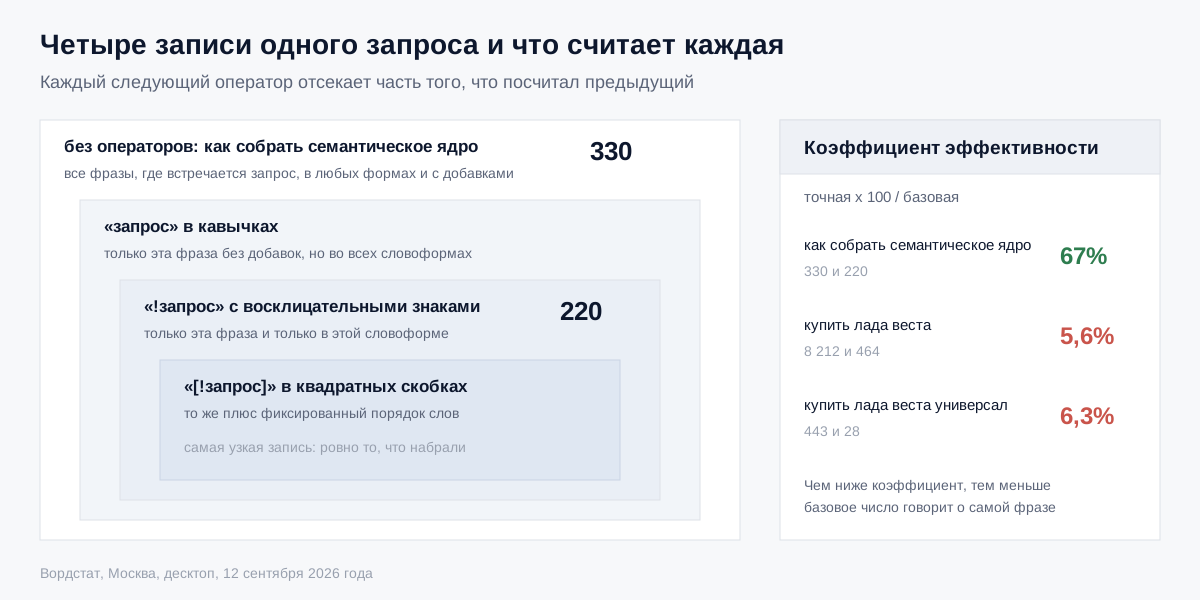 Каждый следующий оператор отсекает часть того, что посчитал предыдущий. Справа отношение точной частотности к базовой
| Запрос | Базовая | Точная | Коэффициент |
как собрать семантическое ядро |
330 |
220 |
67% |
купить лада веста |
8 212 |
464 |
5,6% |
купить лада веста универсал |
443 |
28 |
6,3% |
У фразы про ядро спрос сосредоточен в самой формулировке. Базовая частотность «купить лада веста» в двадцать пять раз больше, чем у первой фразы, а набирается она сотнями разных фраз, включая запчасти и объявления частников. Коэффициент решает, по какой из двух частотностей считать спрос на фразу. Выше 30 % — по базовой. Ниже 10 % — по точной: базовое число набрано другими фразами. Между ними — по базовой, если собранные формулировки про тот же предмет, и по точной, если среди них много чужого. Из ядра фраза при этом не выбывает: «купить лада веста» с коэффициентом 5,6 % остается головным запросом дилерского центра, и SEO-продвижение по нему идет как обычно; только спрос считают как 464 запроса в месяц, остальное из 8 212 набрано другими фразами.
Вордстат показывает число за последний месяц, а спрос сезонный у большинства тематик: у дилерского центра зимние шины спрашивают осенью, а трейд-ин — в начале года. В файл ядра поэтому записывают среднемесячное число за год: сборщику задают годовой период, а при ручном сборе двенадцать месяцев с вкладки «Динамика» складывают и делят на двенадцать. Числа в этой статье взяты за один месяц: для примера этого хватает.
Этап 3. Чистка семантического ядра
Интент — это то, зачем человек набрал запрос: купить, сравнить, починить самому, почитать отзывы. В файле ядра интенты сводят к двум: коммерческий, когда человек хочет купить или заказать, и информационный, когда хочет разобраться. Чистка — это удаление запросов, на которые сайт ответить не может: чужой интент, чужой регион, чужие бренды, товары, которых нет в ассортименте. Мусор появляется на расширении: сервисы собирают всё, что содержит вашу фразу, включая чужие бренды, другие регионы и чужой интент.
Сколько его бывает, видно на том же маркерном запросе. Из 175 фраз, собранных по «лада веста купить», 48 спрашивают запчасти и аксессуары: диски, двигатель, коврики, лобовое стекло, тормозные колодки. Каждая четвертая фраза списка. Если сложить точную частотность всех 175 фраз, выйдет 1 619 запросов в месяц, и 314 из них, пятая часть, приходится на запчасти. Дилерскому центру они не нужны. Интернет-магазину автозапчастей нужны именно они, и это тот же список, разобранный под другой сайт.
| Что убирают | Как выглядит у дилерского центра | Чем ловят |
Чужой интент |
«лада веста отзывы владельцев», «лада веста ремонт самостоятельно» |
Стоп-слова: отзывы, форум, самостоятельно, схема, реферат |
Другой регион |
«лада веста купить в казани» |
Общий список городов, из которого убран свой |
Чужие бренды и модели |
«лада веста или киа рио что лучше», «лада веста купить у дилера X» |
Список конкурентов и марок вне ассортимента |
Товары и услуги, которых нет |
«лада веста спорт» при отсутствии версии в наличии |
Ручной просмотр по группам слов |
Опечатки и дубли |
«лада веста купить» и «лада веста куить» |
Сборщик отмечает фразы с опечатками; их убирают, спрос по ним и так учтен в правильной форме |
Точная частотность ниже порога |
Фраза с базовой 500 и точной 3 |
Фильтр по колонке точной частотности |
Порог отсечения по точной частотности мы ставим на 10: запрос, который спрашивают реже десяти раз в месяц, в одиночку трафика не приносит. На расширении сборщик отсекал по базовой частотности, здесь отсекают по точной, и убирается намного больше. Порог этот наш, и его двигают в двух случаях. В узкой нише, где всего спроса несколько сотен запросов в месяц, отсечка по 10 срезает половину ядра; там порог опускают до нуля и отбирают по интенту. При дорогой заявке порог тоже опускают: у IT-интегратора запрос «внедрение битрикс24 в производственной компании» набирают единицы раз в месяц, и каждый такой переход ближе к сделке, чем сотня переходов из товарного спроса.
Стоп-слова делят на общие и частные. Общие составляют однажды и переносят из проекта в проект: города, слова «бесплатно», «скачать», «самостоятельно», «отзывы», «фото». Частные составляют под конкретный сайт: чужие бренды, услуги, которых нет, филиалы в других городах. Частный список собирают ручным просмотром, и это самая долгая часть работы. Применяют оба списка одинаково: в Key Collector их загружают в окно «Стоп-слова», и программа отмечает все фразы с этими словами; в Excel то же делает фильтр по столбцу с условием «содержит».
Этап 4. Кластеризация запросов
Кластеризация — это группировка запросов по совпадению выдачи. Два запроса попадают в одну группу, если по ним в топ-10 стоят одни и те же страницы: значит, поиск считает, что на оба отвечает одна страница. Сходство формулировок при этом ничего не решает.
| Тип | Как работает | Для чего берут |
Hard |
Общие страницы должны быть у всех запросов группы сразу |
Коммерческие запросы: две разные потребности на одной странице стоят дороже, чем лишняя страница |
Soft |
Общие страницы должны быть хотя бы с одним запросом группы |
Информационные запросы и одиночки, оставшиеся после Hard |
Третий вариант, Balance, стоит между ними по жесткости; его берут, когда Hard дробит ядро на одиночки, а Soft склеивает лишнее. На практике чаще хватает двух прогонов, Hard и Soft.
Второй параметр — сколько адресов в топ-10 должны совпасть у двух запросов, чтобы они попали в одну группу. Обычное значение три; чем оно выше, тем мельче получаются группы.
В инструменте «Кластеризация запросов» engine.seointellect.ru [7] прогон настраивают четырьмя полями: запросы, вид группировки, порог совпадения, регион. Запросы берут из файла по одному предмету за прогон: так группы одного предмета оказываются в результате рядом. Поле «Мой сайт» на первом прогоне оставляют пустым: оно нужно, когда страницы под запросы уже есть и надо разложить запросы по ним.
Пример: как разложились запросы дилерского центра Lada. Двенадцать фраз из собранного списка прогнали через инструмент engine.seointellect.ru, метод Hard, совпадение по трем адресам, Яндекс, Москва, 12 сентября 2026 года. Четыре запроса, два про запчасти и два про вторичный рынок, оставлены в списке нарочно: на них видно, как кластеризация выдает то, что чистка должна была убрать.
| Запрос | Базовая | Куда попал |
купить лада веста |
8 212 |
Группа 1 |
лада веста купить в москве |
883 |
Группа 1 |
купить лада веста седан |
303 |
Группа 1 |
лада веста купить цена |
207 |
Группа 1 |
купить лада веста новую у официального дилера |
152 |
Группа 1 |
купить лада веста кросс |
1 197 |
Отдельно |
купить лада веста универсал |
443 |
Отдельно |
купить лада веста бу |
325 |
Отдельно |
лада веста купить авито |
262 |
Отдельно |
купить диски на лада веста |
241 |
Отдельно |
купить лада веста спорт |
195 |
Отдельно |
коврики лада веста купить |
102 |
Отдельно |
Отдельная страница под седан дилерскому центру не нужна: по этому запросу выдача та же, что по общему «купить лада веста». Кросс и универсал, наоборот, требуют своих страниц: по ним в топ-10 стоят карточки конкретных версий. «Бу» и «авито» ушли поодиночке, потому что там выдачу занимают площадки объявлений, и с новой машиной этот интент не совпадает. Диски и коврики отделились как чужой предмет: на них у дилерского центра страниц нет вовсе. Спорт отделился как отдельная версия, и решение по нему то же, что по кроссу: если версия есть в наличии, ей нужна страница, если нет, запрос убирают, вернувшись к чистке.
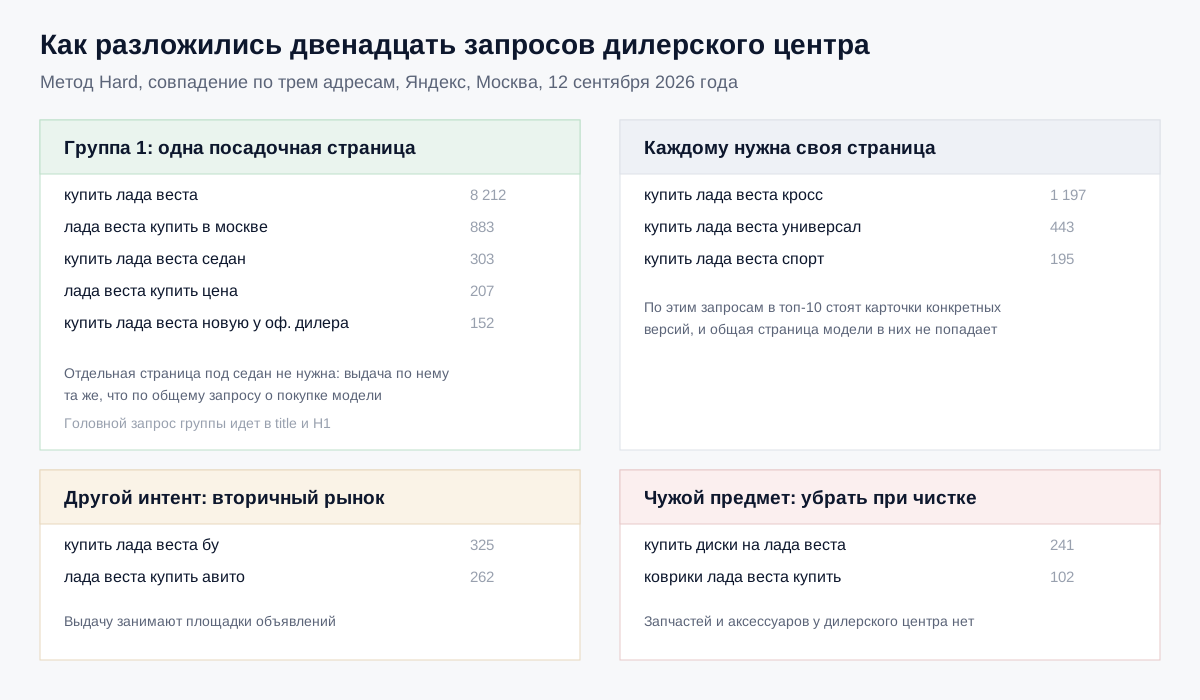 Результат прогона методом Hard. Формулировки похожи, а выдача по ним расходится, и группу определяет именно она
У запроса, не попавшего ни в одну группу, две возможные причины, и различают их по выдаче. Если в топ-10 стоят страницы того же типа, что у вас, только про другую версию предмета, запросу нужна отдельная страница, как кроссу и универсалу. Если там площадки объявлений, форумы или чужой предмет, запрос попал в ядро по ошибке и должен был уйти при чистке, как диски и коврики. Одиночки, по которым выдача ясного ответа не дала, прогоняют повторно по методу Soft: он мягче и собирает в группы то, что Hard оставил поодиночке. Полученные группы добавляют в общий файл к группам Hard.
Этап 5. Разбивка по страницам
Один кластер — одна страница, на которую ведут его запросы, и обратно: одну страницу продвигают по одному кластеру. Головной запрос кластера идет в title и H1, остальные запросы кластера — в заголовки разделов и в текст.
Использовать готовое ядро дальше будут двое. Копирайтеру нужны кластер, головной запрос и словарь темы, то есть слова, которые есть у всех конкурентов из топа; в сервисах их называют LSI-словами. Тому, кто отвечает за структуру сайта, нужен список страниц, которых пока нет.
- Сверить кластеры со структурой сайта. У каждого кластера должен быть адрес. Кластеры без адреса складываются в список страниц, которые предстоит создать.
- Проверить релевантные страницы. Инструмент «Релевантные страницы» в engine.seointellect.ru [8] показывает, какую страницу сайта Яндекс уже считает подходящей под запрос. Если это не та страница, которую вы назначили, дальше идет разбор: или назначение неверно, или две страницы конкурируют между собой.
- Развести каннибализацию. Когда две страницы сайта отвечают на один интент, поиск выбирает между ними сам и меняет выбор от проверки к проверке. Каннибализацию лечат разведением тем по страницам или склейкой: одну страницу убирают, а ее адрес перенаправляют на вторую редиректом 301.
- Собрать ТЗ на страницу. Из кластера, требований к объему (его берут по средней длине текстов конкурентов из топ-10) и словаря темы собирают задание копирайтеру. Отдельно разобраны релевантная страница под запрос и составление title под кластер.
- Расставить приоритеты. Первыми берут кластеры с готовыми страницами и большим спросом: там правят готовое, а новые страницы пишут следующим заходом.
Чем собирать, кроме Key Collector
Key Collector (в поиске его пишут и кириллицей: кей коллектор) остается основной программой для больших ядер, но он платный и работает только на Windows. Лицензия бессрочная, на один компьютер, 2200 рублей; текущая версия четвертая [3]. Сбор из Вордстата в программе работает, но разработчик предупреждает, что прямой сбор может ломаться при изменениях сервиса, и не гарантирует его; надежнее подключить в настройках программы официальный API Вордстата: ключ выдает Яндекс в кабинете Yandex Cloud, вставить его в настройки можно самому.
Тот же API открыт и без Key Collector: три метода отдают топ запросов по фразе, динамику и распределение по регионам [4]. Собственный скрипт поверх них — работа для программиста, маркетолог сам этого не соберет; зато после подключения сбор идет сам, и частотность можно перепроверять хоть раз в месяц.
Букварикс берут для первой прикидки: это готовая база запросов, по которой за минуту видно, какой в тематике вообще спрос. Полноты от нее не ждут: база обновляется реже, чем сам Вордстат.
Из онлайн-сервисов весь маршрут без программы на компьютере закрывает engine.seointellect.ru: сбор запросов, частотность, кластеризация и LSI-слова. Кластеризацию и сбор частотности делает Rush Analytics в браузере; KeyAssort раскладывает готовый список по страницам, но это программа для Windows. Оба платные.
Сравнение сервисов для работы с ядром мы разбирали отдельно.
Частотность по Google российскому пользователю собирать сложнее. Keyword Planner работает внутри рекламного кабинета Google Ads, а продажу рекламы в России Google приостановил 4 марта 2022 года [5]; аккаунту без действующих кампаний планировщик показывает диапазоны вместо чисел. Поэтому в российской практике ядро считают по Вордстату, а по Google смотрят выдачу: если по головным запросам там стоят те же типы страниц, что в Яндексе, ядро годится для обеих систем.
Информационное ядро и ядро под контекстную рекламу
Пять этапов построены на умножении предмета на свойства: так собирают ядро для товаров и услуг. Информационное ядро устроено иначе: предмет там один, а различаются вопросы к нему.
| Признак | Ядро для товаров и услуг | Информационное ядро |
Откуда берут маркеры |
Категории и фильтры каталога |
Вопросы клиентов, подсказки поиска, «Топы запросов» |
Что умножают |
Предмет на свойства |
Предмет на вопросительные слова: как, что такое, сколько, почему |
Тип группировки |
Hard |
Soft |
Куда ведет кластер |
Карточка, категория, страница услуги |
Статья блога |
Чем измеряют результат |
Заявки и звонки |
Переходы, дочитывания, переходы в коммерческий раздел |
Для ядра под контекстную рекламу остаются маркерные запросы, расширение, обе частотности и составленный список стоп-слов; точная частотность здесь нужна, чтобы оценить, сколько показов соберет группа объявлений. Иначе делают три вещи.
Первое: кластеризация по выдаче не нужна. Группы объявлений собирают по смыслу: один предмет и один маркер на группу, потому что под каждую группу пишут свое объявление и ведут на свою страницу. Например, «лада веста купить», «лада веста цена» и «лада веста кросс купить» идут в три разные группы, хотя на сайте первые две легли бы на одну страницу.
Второе: стоп-слова из этапа 3 идут в кампанию как минус-слова: объявление не показывается по «лада веста отзывы» и «лада веста ремонт самостоятельно», а сами фразы сохраняются в файле для проверки.
Третье: порог по частотности не ставят вовсе, и минимальную частотность в настройках сборщика перед расширением тоже сбрасывают в ноль, иначе редкие фразы не соберутся. Добавить в группу запрос с пятью показами в месяц стоит тех же усилий, что с пятьюстами, а заявка с него приходит такая же.
Финальная версия файла семантического ядра
Файл собирают из выгрузки сборщика: после чистки запросы с двумя частотностями выгружают в Excel, к ним добавляют колонку группы из результата кластеризации, а три последние колонки заполняют вручную.
| Колонка | Что в ней | Откуда берется |
Запрос |
Формулировка в том виде, в каком ее набирают |
Расширение списка |
Группа |
Название кластера |
Кластеризация |
Базовая частотность |
Число из Вордстата без операторов |
Сбор частотности |
Точная частотность |
Число по оператору «!» |
Сбор частотности |
Интент |
Коммерческий или информационный |
Проставляется один раз на группу: по тому, что стоит в топ-10 по ее головному запросу |
Тип страницы |
Карточка, категория, услуга, статья |
Проставляется по интенту |
Посадочная страница |
Адрес на сайте или пометка «создать» |
Разбивка по страницам |
Группы в файле отделяют друг от друга пустой строкой или заливкой: дальше с этим файлом работают вручную, и границы групп нужны глазу. Колонки интента и типа страницы отвечают на вопрос, что со списком делать: без них файл остается перечнем фраз.
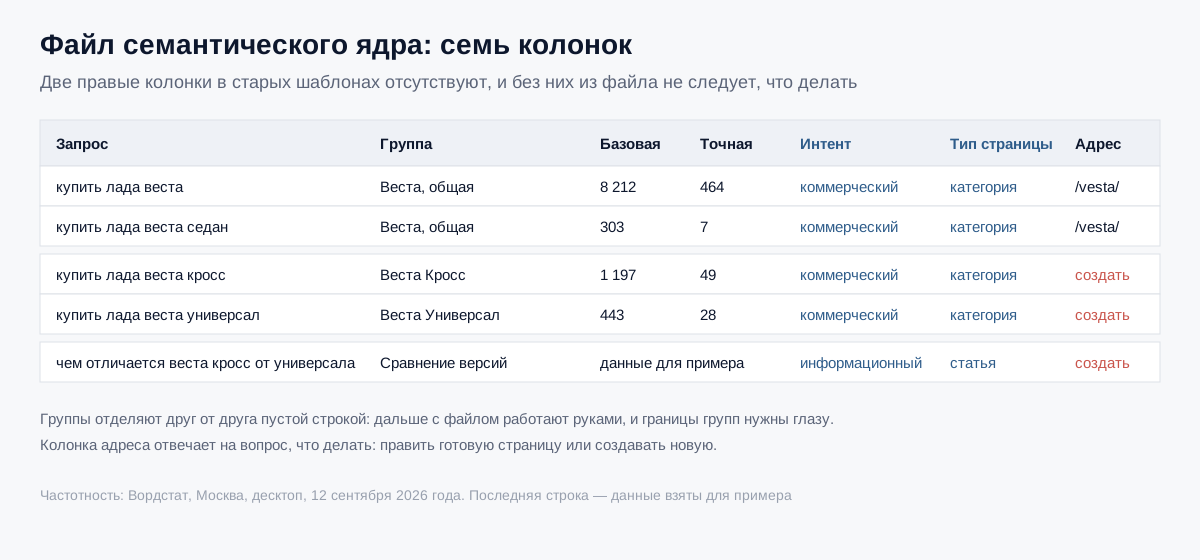 Синим выделены две колонки, которых нет в старых шаблонах. Без них из файла не следует, какую страницу делать
Как проверить, что ядро собрано правильно
- Открыть файл ядра и найти кластеры без адреса. Каждый такой кластер означает либо страницу, которую предстоит создать, либо группу, которую собрали зря. Различают по ассортименту: если предмет у сайта есть, страницу создают, если предмета нет, группу убирают.
- Проверить релевантные страницы по головным запросам кластеров. Яндекс должен считать подходящей ту же страницу, которую назначили вы, и по всем запросам группы одну и ту же. Расхождение означает либо ошибку назначения, либо каннибализацию: две страницы отвечают на один интент.
- Выгрузить топ-10 по головному запросу и посмотреть, страницы какого типа там стоят. Если в выдаче карточки товаров, а вы назначили статью, ошибся кто-то один, и это не поисковая система.
- Сверить ядро со словарем темы. Инструмент «LSI-слова» (это и есть словарь темы) в engine.seointellect.ru [9] по списку головных запросов показывает слова, общие для страниц из топ-10. Термин, который есть у всех конкурентов и которого нет ни в одном запросе ядра, означает группу запросов, пропущенную при сборе.
Последняя проверка ловит ошибку, которую не видно по собственному списку: ядро может быть большим и чистым, а часть спроса в нем отсутствует, потому что маркеры для нее не были выписаны на первом этапе.
Частые вопросы
Сколько запросов должно быть в семантическом ядре?
Числа, общего для всех сайтов, нет. Размер ядра задает спрос тематики и ассортимент: у дилерского центра одной марки это тысячи запросов, у IT-интегратора с четырьмя услугами их сотни.
Сколько времени занимает сбор семантического ядра?
На сайт в несколько десятков страниц уходит два-пять рабочих дней. Быстро проходит второй этап: сбор формулировок и частотности идет пакетом, и время на него тратит программа. Дольше всего идут чистка и составление частного списка стоп-слов, потому что их делают вручную.
Можно ли собрать семантическое ядро бесплатно?
Маршрут проходится бесплатно, если ядро небольшое. Вордстат бесплатный, подсказки поиска бесплатны, Яндекс Вебмастер показывает свои запросы без оплаты. Платить приходится за пакетный сбор и за кластеризацию, когда запросов тысячи.
Чем семантическое ядро отличается от списка ключевых слов?
Список — это выгрузка сборщика как есть. Ядром он становится, когда прошел чистку и группировку и у каждой группы появился адрес страницы.
Нужно ли пересобирать ядро и как часто?
Целиком ядро пересобирают при смене ассортимента или структуры сайта. Раз в полгода проверяют частотность и добавляют новые формулировки: спрос меняется, появляются новые модели, услуги и способы спрашивать о том же.
Что делать с запросами, которые не попали ни в один кластер?
Прогнать их по методу Soft. Оставшиеся одиночки проверить по выдаче: свой тип страниц в топ-10 означает отдельную страницу, чужой предмет или площадки объявлений означают мусор.
Источники
- Яндекс Вордстат. Справка. Интерфейс сервиса: вкладки «Динамика», «Регионы», «Топы запросов»
- Microsoft. Справка Excel. Функция СЦЕПИТЬ: заменена функцией СЦЕП, оставлена для обратной совместимости
- Key Collector. Официальный сайт: версия 4, стоимость лицензии, статус функций сбора статистики
- Яндекс. Документация Search API: методы Вордстата GetTop, GetDynamics, GetRegionsDistribution
- РБК. Google приостановила продажу рекламы в России, 4 марта 2022 года
- engine.seointellect.ru. Инструмент «Поиск конкурентов»: engine.seointellect.ru/about/competitors
- engine.seointellect.ru. Инструмент «Кластеризация запросов»: engine.seointellect.ru/about/clustering
- engine.seointellect.ru. Инструмент «Релевантные страницы»: engine.seointellect.ru/about/positions
- engine.seointellect.ru. Инструмент «LSI-слова»: engine.seointellect.ru/about/lsi