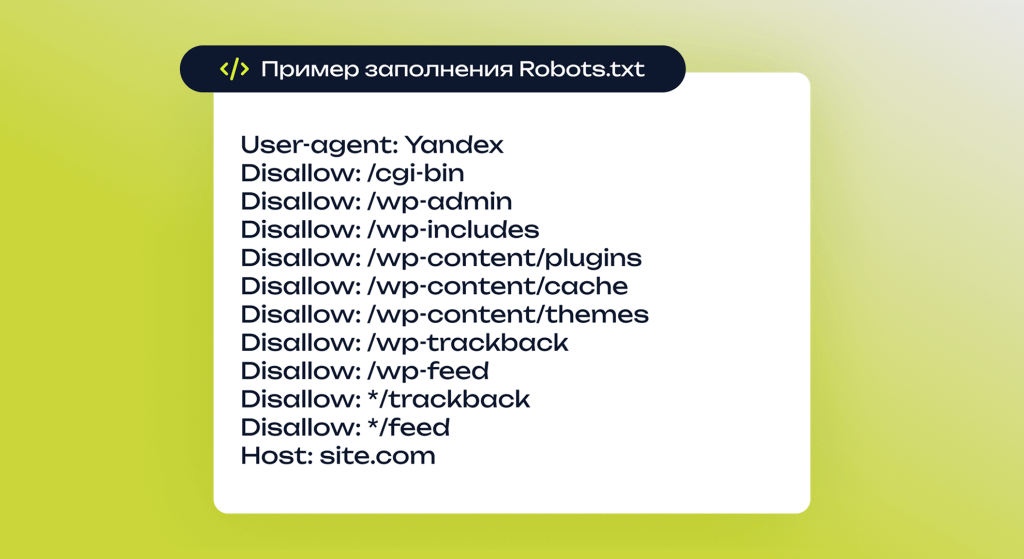
Robots.txt — текстовый файл с инструкциями для поисковых роботов: какие адреса обходить, а какие нет. Лежит в корне сайта, открывается по адресу site.ru/robots.txt. Робот запрашивает его раньше любой страницы сайта. Одной строки в нем хватает, чтобы закрыть от обхода целый раздел.
Robots.txt управляет обходом. Индексирование он не отменяет: закрытая в нем страница все равно может оказаться в поиске. В справке Яндекса это сказано так: «Ограниченные в robots.txt страницы могут участвовать в поиске Яндекса» [1]. Google формулирует то же самое: страница, закрытая в robots.txt, попадет в индекс, если на нее ссылаются с других сайтов, но без описания в сниппете [2].
Чтобы убрать страницу из выдачи, ставят noindex в метатеге. Запрет в robots.txt эту задачу не решает: робот, которому закрыт обход, до noindex не доберется и не выполнит его.
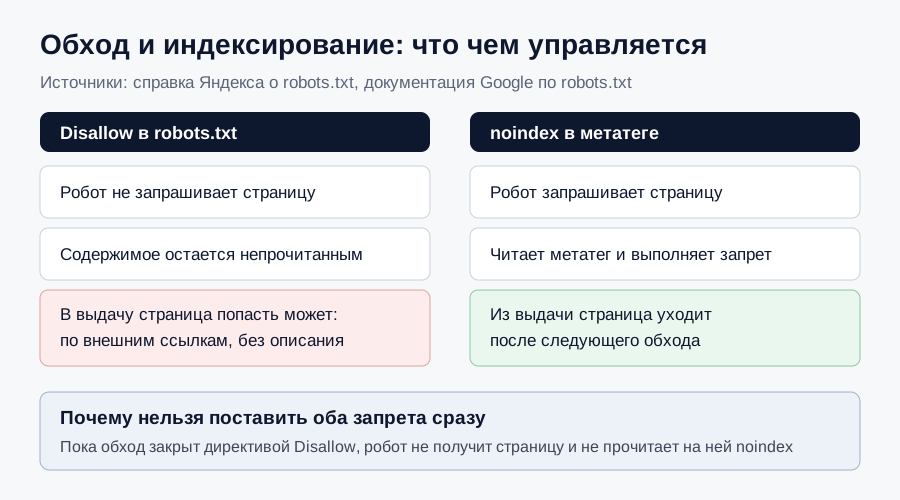 Два запрета решают разные задачи. Поставить оба сразу нельзя: закрытый от обхода робот не прочитает noindex
Сводная таблица директив robots.txt
| Директива | Что задает | Яндекс | |
|
робота, к которому относится группа правил |
поддерживает |
поддерживает |
|
адреса, которые роботу обходить не нужно |
поддерживает |
поддерживает |
|
исключения внутри запрета |
поддерживает |
поддерживает |
|
адрес карты сайта |
поддерживает |
поддерживает |
|
параметры адреса, которые не меняют содержимое страницы |
не поддерживает |
поддерживает |
|
главное зеркало сайта |
не поддерживал никогда |
не учитывает с 2018 года |
|
паузу между запросами робота |
не поддерживает [2] |
не учитывает с 22.02.2018 |
Рабочих директив пять, они в первых пяти строках таблицы. Последние две строки не читает уже никто, хотя их до сих пор копируют в примеры файлов.
Где находится файл и как его создать
Robots.txt находится в корне сайта: https://site.ru/robots.txt. В подкаталоге он не работает, а у поддомена свой файл: для поисковой системы это отдельный сайт.
Имя файла регистрозависимо и пишется строчными латинскими буквами. Robots.txt с большой буквы и «роботс тхт» кириллицей — другие имена: робот запрашивает только /robots.txt.
| Требование | Яндекс | |
Максимальный размер файла |
500 КиБ, все сверх лимита игнорируется [2] |
500 КБ [1] |
Кодировка |
UTF-8, обычный текст |
текст; кириллица в файле запрещена [1] |
Кириллические адреса |
процентная кодировка, домены в Punycode |
процентная кодировка, домены в Punycode [1] |
Расположение |
корневой каталог |
корневой каталог |
Время кеширования файла |
до суток [2] |
не объявлено |
Создать файл можно в любом текстовом редакторе: «Блокнот», TextEdit, редактор кода. Word и другие офисные программы не подходят: они добавляют разметку и невидимые символы. Готовый файл кладут в корневую папку сайта через FTP-клиент, файловый менеджер хостинга или админ-панель движка.
У WordPress, Bitrix и других движков robots.txt бывает виртуальным: физического файла в корне нет, а отдает его сам движок или SEO-плагин. Поэтому после каждой правки файл открывают в браузере и сравнивают с тем, что лежит на диске: если движок отдает свою версию, правка на диске ничего не меняет.
Онлайн-генераторы умеют сгенерировать только типовой набор запретов. Какие разделы закрыть на конкретном сайте, знает только человек, который этот сайт ведет.
Протокол исключений для роботов придумал Мартин Костер в 1994 году, и 28 лет он оставался договоренностью. Официальным стандартом протокол стал в сентябре 2022 года — это RFC 9309 «Robots Exclusion Protocol» [3]. Стандарт описывает синтаксис, алгоритм сопоставления путей и правила кеширования, и отдельно оговаривает: средством защиты robots.txt не служит. Робот, который не собирается соблюдать файл, его не соблюдает.
Коды ответа сервера на запрос robots.txt
Запрос /robots.txt должен возвращать код 200 OK [1]. Остальные ответы Яндекс и Google трактуют по-разному, и от кода ответа зависит, увидит ли робот правила вообще.
Ответ на запрос /robots.txt |
Что делает робот |
200 OK |
обе системы читают файл и применяют правила |
Редирект на другой robots.txt |
Яндекс принимает файл, если в конце цепочки сервер отвечает 200 OK [1]. Google проходит до пяти переадресаций подряд, дальше трактует ответ как ошибку 404 [2] |
404 и другие ответы 4xx, кроме 429 |
Google обходит сайт так, как будто файла нет вовсе [2] |
5xx |
Google не обходит сайт 12 часов, затем до 30 дней применяет последнюю сохраненную версию файла [2] |
Если сервер отвечает редиректом на запрос robots.txt, робот смотрит на последний ответ в цепочке: пока это 200 OK, файл считается найденным.
Директивы
User-agent
Каждая группа правил начинается с нее: директива называет робота, к которому относятся строки ниже.
User-agent: *
Disallow: /admin/

User-agent: Yandex
Disallow: /admin/
* означает «все роботы». Конкретные токены: Yandex и YandexBot у Яндекса, Googlebot, Googlebot-Image у Google.
Файл содержит одну или несколько таких групп, и робот выполняет только ту, которая написана для него: если своя группа есть, общую он игнорирует.
Disallow и Allow
Запрещают и разрешают обход. Поддерживают спецсимволы:
*заменяет любую последовательность символов;$означает конец адреса.
Пример с нашего сайта, где блог лежит в /media/, а служебные файлы движка в /bitrix/:
Disallow: /bitrix/           # служебные файлы движка
Disallow: /search/           # страница поиска по сайту
Disallow: /*?*               # любой адрес с параметром
Disallow: /*.pdf$            # файлы PDF
Allow: /*?utm_source=        # кроме адресов с utm-меткой
Знак $ в четвертой строке закрывает только адреса, которые заканчиваются на .pdf. Без него под запрет попал бы любой адрес, где .pdf стоит в середине, например /media/otchet.pdf-2026/. Последняя строка открывает адреса с меткой кампании, хотя строкой выше закрыты все адреса с параметрами: это и есть исключение внутри запрета.
Правило конфликта. В старых руководствах по robots.txt написано, что приоритет у директивы, которая стоит выше. На деле выигрывает правило с самым длинным совпадающим путем, а при равной длине Google применяет наименее строгое из двух, то есть Allow [2].
Disallow: /bitrix/
Allow: /bitrix/templates/seointellect/assets/
Служебный раздел движка закрыт целиком, а папка со стилями и скриптами шаблона открыта: путь во второй строке длиннее, и по нему робот применяет Allow. Без этого исключения он отрендерил бы страницы сайта без стилей.
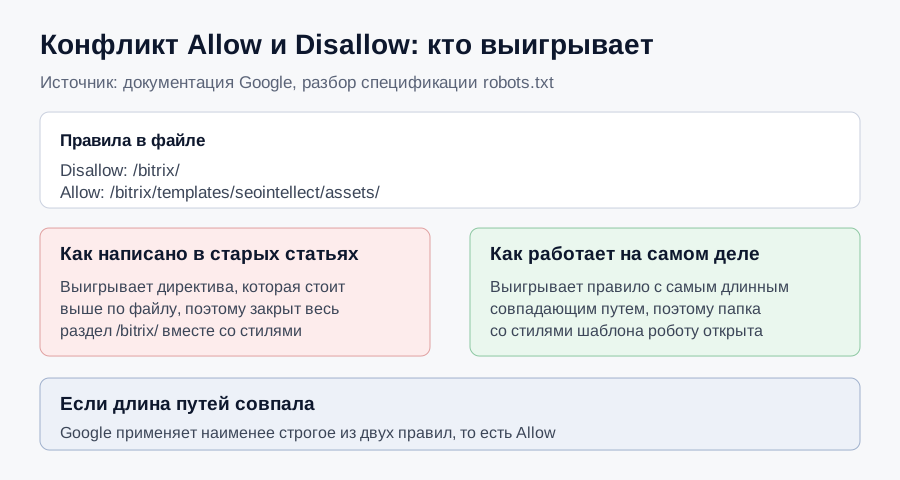 Правило про «приоритет у директивы выше» неверно. Совпадение считается по длине пути, источник — документация Google
Sitemap
Указывает адрес карты сайта. Пишется полным адресом и может повторяться:
Sitemap: https://site.ru/sitemap-1.xml
Sitemap: https://site.ru/sitemap-2.xml
Директива не привязана к группе User-agent и действует для всех роботов.
Clean-param
Директива Яндекса: сообщает, что параметр в адресе на содержимое страницы не влияет. Все адреса с этим параметром робот сведет к адресу без него, и участвовать в поиске будет он [4].
Clean-param: utm_source&utm_medium&sort /catalog/Первое поле перечисляет параметры через &, второе задает префикс пути, для которого правило работает. Длина одного правила ограничена 500 символами, и длинный список параметров разбивают на несколько директив.
Clean-param межсекционная: она работает в любом месте файла, и писать ее внутри группы User-agent: Yandex не требуется [4]. Если адрес одновременно попадает под Clean-param и под Disallow, приоритет у Disallow [4]. Ту же задачу закрывает инструмент «Настройка GET-параметров» в Вебмастере.
У Google аналога нет: инструмент «Параметры URL» в Search Console закрыт, а страницы с незначащими параметрами склеивают через rel="canonical".
Комментарии
Все, что стоит после # до конца строки, роботы игнорируют. Комментарием помечают, почему раздел закрыт: через год этого не помнит никто, включая автора файла.
Директивы, которых больше нет
Host. Указывала роботу Яндекса главное зеркало сайта. Яндекс не поддерживает ее с 2018 года. Вместо нее ставят 301-редирект на выбранную версию и пользуются инструментом «Переезд сайта» в Вебмастере.
Crawl-delay. Задавала минимальный интервал между запросами робота. Яндекс перестал ее учитывать 22 февраля 2018 года: теперь скорость обхода настраивают в Вебмастере, в разделе «Скорость обхода». Google crawl-delay не поддерживает вовсе: в перечне полей, которые он читает, этой директивы нет [2].
Если в вашем файле такие строки есть, они просто не читаются. Вреда от них нет, пользы тоже.
Что закрывать и чего в файле быть не должно
Настройка сводится к двум решениям: какие разделы роботу обходить незачем и какие адреса он обязан получить в любом случае.
Из обхода на типовом сайте убирают:
- админ-панель и служебные разделы:
/admin/,/bitrix/,/wp-admin/; - корзину, оформление заказа, личный кабинет;
- результаты внутреннего поиска;
- страницы сравнения и избранного;
- технические файлы, которые на отображение страниц не влияют: логи, бэкапы, выгрузки.
Скрипты и стили закрывать нельзя. Робот рендерит страницу так же, как браузер, и без CSS и JS увидит ее сломанной.
Чего в robots.txt быть не должно:
- страниц, которые надо убрать из выдачи: для этого есть
noindex; - дублей, которые уже в индексе: сначала
canonicalили 301, обход закрывают после; - адресов с личными данными: файл открыт всем, и запрет в нем работает как указатель, где искать.
Пример robots.txt для сайта автодилера
User-agent: *
Disallow: /personal/
Disallow: /cart/
Disallow: /order/
Disallow: /search/
Disallow: /*?sort=
Disallow: /*?display=
Allow: /catalog/
Allow: *.css
Allow: *.js

User-agent: Yandex
Disallow: /personal/
Disallow: /cart/
Disallow: /order/
Disallow: /search/

Clean-param: utm_source&utm_medium&utm_campaign&sort&display /

Sitemap: https://site.ru/sitemap.xml
Первая группа написана для всех роботов. Закрыты личный кабинет, корзина, оформление заказа и внутренний поиск: эти страницы нужны посетителю и бесполезны в выдаче. Закрыты сортировки, потому что каждая из них порождает копию каталога по другому адресу.
Allow на CSS и JS поставлен намеренно: даже если движок держит их в закрытой папке, робот должен их получить, иначе отрендерит сломанную страницу.
Вторая группа повторяет запреты для Яндекса, потому что робот со своей группой общую не читает. Clean-param вынесена из групп отдельной строкой: она межсекционная и снимает utm-метки и параметры сортировки со всего сайта.
Строка Sitemap стоит в конце и работает для всех роботов.
Чего в примере нет и быть не должно: Host, Crawl-delay и запрета на весь раздел /catalog/. Разделы на другом движке называются иначе, устройство групп при этом не меняется.
Как проверить robots.txt
Яндекс Вебмастер. Раздел «Инструменты», дальше «Анализ robots.txt». Файл проверяют и по адресу сайта, и вставив текст вручную. Второй способ удобен, когда правки еще не выложены. Сервис показывает, какие правила робот учел, какие строки прочитать не смог, и отвечает по конкретному адресу, открыт он для обхода или запрещен. Здесь же хранятся прежние версии файла, до 100 за последние полгода. После внезапного падения трафика первым делом смотрят сюда: не менялся ли robots.txt.
Google Search Console. Отчет по robots.txt в разделе «Настройки»: видно, когда файл последний раз запрашивали, какой код ответа получили и нашлись ли в нем ошибки.
Вручную. Откройте site.ru/robots.txt в браузере. Должен открыться текст файла. Страница 404 означает, что по этому адресу файла нет.
Проверять robots.txt стоит после каждого переезда сайта и каждого обновления движка.
Ошибки, которые встречаются чаще всего
Закрыт весь сайт. Типовой случай после переноса сайта с тестового сервера:
User-agent: *
Disallow: /
Главная страница и все остальные страницы становятся для робота недоступны, сайт выпадает из выдачи целиком. Яндекс Вебмастер показывает это фатальной ошибкой «Сайт закрыт для индексирования в файле robots.txt» [5]: пока запрет стоит, данные о сайте и его страницах не обновляются.
Файл недоступен по адресу site.ru/robots.txt. Диагностика Вебмастера называет это «Не найден файл robots.txt» [5]. Для Google ответ 404 означает «правил нет, обходим все». Цепочка переадресаций длиннее пяти переходов означает для него то же самое, хотя файл на сервере есть.
Ошибки синтаксиса. Вторая типовая строка диагностики называется «Обнаружены ошибки в файле robots.txt» [5]. Сюда же попадает «Некорректный формат директивы Clean-param». Так помечают правило длиннее 500 символов и правило с недопустимыми символами в префиксе: выполнять его робот не станет.
Закрыты CSS и JS. Без стилей и скриптов робот отрендерит страницу сломанной и оценит именно такую.
Дублями пытаются управлять через Disallow. Запрет обхода не убирает страницу из выдачи. Дубли закрывают через canonical, 301 или noindex.
Кириллица в файле. Яндекс запрещает ее прямо: адреса записывают в процентной кодировке, домены — в Punycode [1].
**Disallow: /*?* одной строкой.** Закрывает все адреса с параметрами разом, включая нужные страницы фильтров и пагинации.
Файл взят готовым шаблоном. Наборы «для WordPress» и «для Bitrix» написаны под структуру, которой на вашем сайте может не быть, и до сих пор таскают за собой мертвые Host и Crawl-delay. Файл, правильный для чужого сайта, на вашем закроет не те разделы. Составить его придется по своей структуре, а шаблон пригодится как список того, о чем стоит подумать.
Частые вопросы
Обязателен ли robots.txt?
Формально нет. Без него роботы считают сайт полностью открытым для обхода. На любом сайте со служебными разделами он все же нужен.
Зачем нужен файл, который не убирает страницы из поиска?
Он сокращает число бесполезных запросов робота. Робот тратит на сайт ограниченное число обращений, и если половина уходит на сортировки и результаты внутреннего поиска, до новых страниц очередь доходит позже.
Как запретить индексацию сайта через robots.txt?
Такой команды в файле нет: Disallow: / останавливает обход, но адреса, на которые ведут внешние ссылки, в индекс попасть могут. Полный запрет индексации собирают из двух частей: метатег noindex на страницах и закрытый доступ на сервере для тестовых версий сайта.
Как закрыть сайт от всех, кроме Яндекса и Google?
Средствами robots.txt эту задачу не решить. Файл соблюдают только те роботы, которые хотят его соблюдать. Настоящее ограничение ставят на уровне сервера.
Через сколько применятся изменения?
Google кеширует файл до суток [2]. У Яндекса проверку можно ускорить через «Анализ robots.txt» в Вебмастере, но переобход самих страниц все равно занимает время.
Можно ли закрыть страницу и от индексирования, и от обхода сразу?
Нельзя одновременно: пока обход закрыт, метатег noindex робот не прочитает. Сначала ставят noindex и ждут, пока страница выпадет из выдачи. Обход закрывают потом, если это вообще нужно.
Источники
- Яндекс Вебмастер. Справка. Использование файла robots.txt
- Google Search Central. How Google interprets the robots.txt specification
- RFC 9309. Robots Exclusion Protocol, сентябрь 2022
- Яндекс Вебмастер. Справка. Директива Clean-param
- Яндекс Вебмастер. Справка. Диагностика сайта: ошибки и рекомендации