Дубли (дубликаты страниц) — это страницы с одинаковым или почти одинаковым содержимым, доступные по разным адресам. В справке Яндекса это сказано так: «Если страницы сайта доступны по разным адресам, но имеют одинаковое содержимое, робот Яндекса может посчитать их дублями» [1]. Дублями считают страницы в пределах одного сайта.
Проблема не в том, что поисковые системы увидят два одинаковых текста. Проблема в том, что из группы дубликатов поисковик выберет одну страницу сам, и это будет не та, которую вы продвигали.
Явные и неявные дубли
У практиков принято делить дубликаты страниц на две группы, и лечатся они разными инструментами.
Явный (полный) дубль — одна и та же страница по двум адресам. Содержимое идентично.
https://site.ru/catalog/tormoznye-kolodki/
https://site.ru/catalog/tormoznye-kolodki/index.php
Неявный (частичный) дубль — страницы совпадают не полностью, но настолько сильно, что поисковые системы не видят между ними разницы. Например, карточка товара, отличающаяся от соседней только артикулом, при одинаковом описании на 400 слов. Или страницы пагинации, где меняется только сетка товаров. Сюда же относят страницы, у которых свой контент занимает пару строк, а весь остальной текст на них общий: тот же блок «о компании» или описание категории, повторенное на сотнях адресов.
Неявные ловятся хуже и вредят чаще. Явный дубль виден сразу, а сорок карточек с идентичным контентом остаются в каталоге годами, и робот выбирает из них одну.
Откуда берутся дубли страниц
Дубликаты страниц редко появляются по чьему-то решению: их создает движок сайта, обычно при настройках, которые никто специально не менял.
Слеш и его отсутствие. /catalog/ и /catalog для сервера это два адреса.
www и без www, http и https. Четыре версии одного сайта, если не настроено главное зеркало.
Служебные окончания. index.php, index.html, default.asp в конце адреса.
GET-параметры. Самый массовый источник. Метки рекламных кампаний, сортировки, фильтры, идентификаторы сессий:
/catalog/tormoznye-kolodki/?utm_source=yandex
/catalog/tormoznye-kolodki/?sort=price
/catalog/tormoznye-kolodki/?PHPSESSID=a1b2c3
Все три отдают ту же страницу, что и /catalog/tormoznye-kolodki/.
Товар в нескольких категориях. Один и тот же аккумулятор доступен из категории, из страницы бренда и из подборки: три адреса, одно содержимое.
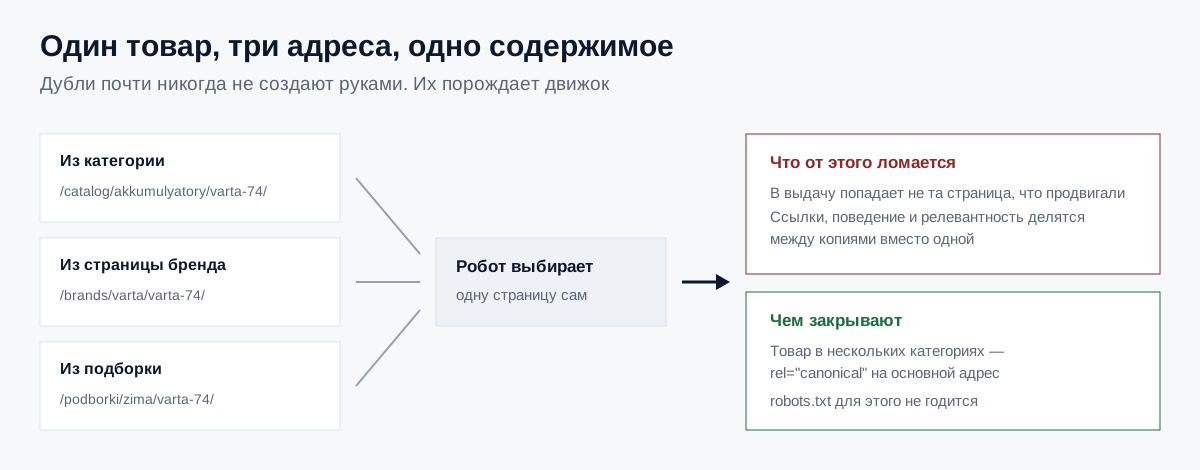 Три адреса с одним содержимым робот сводит к одному, и выбирает не обязательно тот, который продвигали
Пагинация. Страницы 2, 3, 4 списка с одинаковым текстом описания категории сверху.
Версия для печати и AMP-подобные копии.
Регистр в адресе. /Catalog/ и /catalog/ считаются разными URL.
Поиск по сайту. Каждый запрос посетителя создает индексируемый адрес с результатами.
Отдельно стоят внутренний поиск и фильтры интернет-магазина: фасетная навигация из шести фильтров по пять значений генерирует сотни адресов, и почти все они дубли.
Чем дубли опасны
Отдельного фильтра «за дубли» в списках нарушений нет. Google формулирует прямо: наказания за дублирующийся контент не существует, поисковик объединяет сигналы между версиями и выбирает каноническую страницу сам [5]. У Яндекса дубли тоже не значатся среди нарушений, за которые сайт получает ограничение в ранжировании.
Но это не значит, что за дубли ничего не бывает. Санкции наступают в двух случаях. Первый — намеренное копирование ради манипуляции выдачей: копии страниц массово плодят, чтобы занять больше мест. Второй — когда неявных дублей столько, что страницы попадают под «малополезный контент»: у Яндекса это отдельное нарушение, и типовая ситуация здесь — сотни адресов, у которых свой текст занимает строку, а всё остальное одинаково.
Обычный каталог с техническими дублями под санкции не попадает. Вред у него другой, и он наступает без всякого фильтра.
В выдачу попадает не та страница. Яндекс формулирует прямо: «Робот может посчитать дублем и исключить из поиска страницу, которая является целевой и важна для сайта» [2]. Вы оптимизировали категорию, а показывается ее версия с сортировкой по цене, без текста и без перелинковки.
Сигналы делятся. Ссылки, поведение, релевантность распределяются между копиями вместо того, чтобы накапливаться на одной. Страница, на которую вы поставили десять внутренних ссылок и собрали внешние, конкурирует за место с собственной копией, у которой нет ни того, ни другого.
Позиции нестабильны. Робот меняет выбранную страницу от переиндексации к переиндексации, и место в выдаче меняется без видимой причины.
Краулинговый бюджет тратится на мусор. На сайте в 3000 товаров и 40 000 адресов робот обходит служебные адреса, а новые карточки ждут индексации неделями.
Отчеты становятся нечитаемыми. Трафик одной страницы распределен по пяти адресам, и в отчетах не видно, какая категория действительно работает.
Уникальность сайта размывается. Если один и тот же блок текста стоит на сотнях страниц, доля собственного содержимого на каждой падает. Для одной страницы это незаметно, для каталога на три тысячи адресов — уже свойство всего сайта, и оно влияет на то, как поисковые системы его оценивают.
Как найти дубли
Четыре способа, от самого точного к самому грубому.
Яндекс Вебмастер
Самый прямой путь: Вебмастер, дальше «Индексирование», «Страницы в поиске» и вкладка «Исключенные страницы». В колонке «Статус» ставим фильтр «Дубль». Внизу страницы стоит кнопка выгрузки; в скачанном файле дублирующая страница помечена статусом DUPLICATE.
Это данные самого Яндекса о том, какие страницы он уже склеил и какую из группы считает главной. Своими средствами такой список не собрать: он показывает решение поисковой системы, а не догадку о нем.
Google Search Console
Отчет «Индексирование», дальше «Страницы». Ищем причины исключения, которые начинаются со слов «Страница является копией»:
- «…Google выбрал другую каноническую страницу, чем пользователь»: ваш
canonicalпроигнорирован, и стоит разобраться, почему; - «…отправленный URL не выбран в качестве канонического»;
- «…канонический вариант не выбран пользователем».
Третий вариант означает, что вы вообще не указали каноническую страницу и Google решил за вас.
Краулер
Краулер обходит сайт так же, как поисковый робот, и показывает совпадающие title, description и H1. Это единственный способ увидеть частичные дубли, которые поисковик еще не успел склеить.
Подходят Screaming Frog SEO Spider, Netpeak Spider, SiteAnalyzer. Порядок работы одинаковый: сканируем сайт, сортируем по title, ищем повторы. Совпадающие title почти всегда означают страницы с идентичным контентом.
Инструменты разобраны в подборке сервисов для анализа сайтов.
Оператор site:
Самый грубый способ и единственный, для которого не нужен доступ к сайту. Вводим в поиске site:site.ru и сравниваем число найденных страниц с реальным числом страниц каталога. Разница в разы означает дубли.
Числа по оператору приблизительные, и делать на них выводы точнее, чем «в разы больше», нельзя. Как первый сигнал годится, как диагноз нет.
Инструменты: 301-редирект, canonical, метатег robots и Clean-param
Ошибка почти всегда одна: берут robots.txt и закрывают всё подряд. Для этого robots.txt не годится. В справке Яндекса сказано: «Ограниченные в robots.txt страницы могут участвовать в поиске Яндекса» [3]. Запрет обхода не убирает страницу из выдачи, он лишь мешает роботу увидеть, что на ней написано. Хуже того: если на закрытой странице стоит метатег robots со значением noindex, робот его не прочитает, потому что не зайдет на страницу.
| Тип дубля | Чем закрывать |
www / без www, http / https |
301-редирект на выбранную версию |
Слеш в конце, |
301-редирект |
Регистр в адресе |
301-редирект на нижний регистр |
Товар в нескольких категориях |
|
Сортировки и метки в URL |
|
Пагинация |
|
Результаты поиска по сайту |
метатег |
Версия для печати |
метатег |
Фильтры без спроса |
метатег |
301-редирект
Самый сильный сигнал. Применяется, когда дубль не нужен вообще: старый адрес отдает код 301 и ведет на новый. Google называет 301-редирект сильным сигналом канонизации наравне с rel="canonical" [6].
rel="canonical"
Применяется, когда обе страницы должны остаться доступны людям. В <head> неглавной страницы:
<link rel="canonical" href="https://site.ru/catalog/tormoznye-kolodki/" />Это подсказка, а не команда. Google может ее проигнорировать, если содержимое страниц слишком разное; именно это и означает статус «Google выбрал другую каноническую страницу».
Метатег robots со значением noindex
Убирает страницу из выдачи:
<meta name="robots" content="noindex, follow" />Здесь важно не перепутать два разных инструмента с похожими названиями. noindex в этом примере — значение метатега robots, оно понятно обеим поисковым системам и относится ко всей странице. Парный тег <noindex>…</noindex>, которым закрывают кусок текста внутри страницы, — это собственное расширение Яндекса, Google его не понимает, и к дублям он отношения не имеет.
follow оставляют, чтобы вес по ссылкам с этой страницы продолжал передаваться.
Условие одно: страница должна оставаться открытой для обхода в robots.txt. Метатег на странице, закрытой в robots.txt, не работает никогда: робот до него не доходит.
Clean-param в robots.txt
Директива robots.txt для роботов Яндекса. Сообщает, что параметр на содержимое страницы не влияет:
Clean-param: utm_source&utm_medium&sort /catalog/Если адрес одновременно попадает под Clean-param и под Disallow, приоритет у Disallow: робот такую страницу не обходит [4]. Ту же задачу закрывает инструмент «Настройка GET-параметров» в Яндекс Вебмастере — там это делается без правки robots.txt.
У Google аналога нет: инструмент «Параметры URL» в Search Console закрыт, и параметры обрабатываются через canonical.
Что принимают за дубль по ошибке
Часть страниц, попавших в список «найденных дублей», дублями не является, и склейка таких страниц вредит.
Две статьи на близкие темы. «Как собрать семантику» и «Сервисы для работы с семантикой» пересекаются по словам, но отвечают на разные вопросы. Если они делят один запрос и мешают друг другу, это каннибализация, а не дубль. Лечится не редиректом, а разведением: одна страница переписывается под свой интент, вторая под свой.
Карточки товаров одной линейки. Тормозные колодки одной серии под четыре модели автомобиля — четыре разных товара, каждый со своим спросом. Склеивать их в одну карточку значит терять четыре запроса вместо одного.
Страницы под города. Если у филиала свой адрес, телефон и условия доставки, страница уникальна по смыслу, даже если абзац описания услуги совпадает. А вот один и тот же текст, скопированный на тридцать поддоменов, — это дубли.
Простая проверка перед склейкой: посмотрите в Метрике, по каким запросам приходят на обе страницы. Разные запросы означают, что перед вами не дубль. Совпадающие запросы означают дубль или каннибализацию, и дальше решают по тому, отличается ли содержимое.
Порядок работ по дублям
- Настроить главное зеркало и редиректы: один протокол, одна версия домена, один вариант слеша. Это чинится один раз и снимает самую массовую группу.
- Выгрузить из Вебмастера список со статусом
DUPLICATEи разобрать по причинам. - Прогнать сайт краулером, отсортировать по title, найти частичные дубли.
- Проставить
canonicalна карточках и в пагинации. - Закрыть служебные разделы метатегом
robots. - Дописать
Clean-paramпод метки и сортировки. - Через две-три недели повторить выгрузку из Вебмастера и сравнить.
Последний шаг пропускают чаще всего, а он единственный показывает, сработало ли.
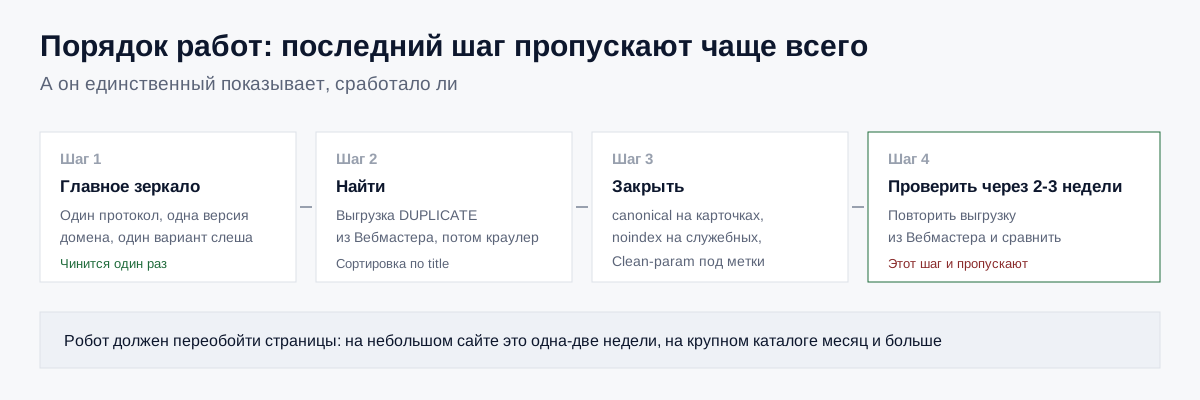 Первый шаг чинится один раз и снимает самую массовую группу. Последний пропускают чаще всего, а без него неизвестно, сработали ли правки
Частые ошибки
Закрывают дубли в robots.txt. Страницы остаются в поиске, только без описания: запрет обхода не убирает адрес из выдачи.
Ставят canonical на страницу с другим содержимым. Поисковик проигнорирует, а вы будете считать задачу закрытой.
Ставят canonical и 301 одновременно на разные адреса. Сигналы противоречат друг другу, робот выбирает сам.
Забывают про пагинацию. Страницы 2 и дальше с одинаковым title и одинаковым текстом сверху дают типовой частичный дубль в каталоге.
Удаляют дубли, не проверив трафик. Иногда «дубль» — это страница, которая как раз и приносит посетителей. Перед удалением стоит посмотреть в Метрике, что на этой странице происходит.
Проверяют один раз. Дубли на живом сайте появляются постоянно: с новой рекламной кампанией, с новым фильтром, с переносом товара в другую категорию. Проверка наличия дублей встает в регулярный список вместе с битыми ссылками: при продвижении сайта это такая же рутина, как контроль индексации.
Частые вопросы
Понижают ли позиции за дубли и бывают ли за них санкции?
Отдельного фильтра «за дубли» нет ни у Яндекса, ни у Google, и обычный каталог с техническими дубликатами под санкции не попадает. Позиции падают по другой причине: в выдачу попадает не та страница, сигналы делятся между копиями, а близкие страницы начинают конкурировать друг с другом. Санкции возможны в двух случаях: когда копии плодят намеренно ради манипуляции выдачей и когда неявных дублей столько, что страницы подпадают под нарушение «малополезный контент» у Яндекса.
Считается ли дублем страница на поддомене?
Для поисковика это другой сайт, но проблема та же: два адреса с одинаковым содержимым конкурируют между собой. Решается так же, редиректом или каноническим адресом.
Нужно ли закрывать пагинацию от индексации?
Нет. Страницы пагинации должны обходиться, иначе робот не увидит товары в глубине списка. Достаточно сделать им уникальные title и canonical на себя.
Что делать с UTM-метками?
Для Яндекса подходит Clean-param в robots.txt или настройка GET-параметров в Вебмастере, для Google — canonical на адрес без параметров.
Вредят ли дубли, если они закрыты в robots.txt?
Да. Робот не видит их содержимого, но адреса остаются доступны и могут показываться в выдаче без описания. Правильный порядок обратный: сначала открыть страницу для обхода, поставить метатег robots или canonical, дождаться переиндексации и только потом при желании закрывать обход.
Чем частичный дубль отличается от неуникального текста?
Неуникальный текст скопирован с чужого сайта, а частичный дубль повторяется внутри вашего. Первое решается переписыванием, второе канонизацией. Про первое подробнее в статье про уникальность текста.
Как быстро уходят дубли после правок?
Робот должен переобойти страницы. На небольшом сайте это одна-две недели, на крупном каталоге месяц и больше. Ускорить можно переобходом страниц в Вебмастере.
Источники
- Яндекс Вебмастер. Справка. Дублирование страниц
- Яндекс Вебмастер. Справка. Чем плохи дубли
- Яндекс Вебмастер. Справка. Использование файла robots.txt
- Яндекс Вебмастер. Справка. Директива Clean-param
- Google Search Central. Duplicate content и объединение сигналов между версиями страницы
- Google Search Central. Consolidate duplicate URLs: методы канонизации