Метатег — это элемент HTML внутри блока <head>, который передает поисковому роботу и браузеру служебные сведения о странице. Выглядит он так:
<meta name="description" content="МРТ коленного сустава: 4 900 ₽, заключение за 40 минут" />Атрибут name называет тег, атрибут content хранит его значение. Такие служебные сведения называются метаданными: посетителю веб-страницы они не видны, а поисковая система по ним решает, как страница выглядит в выдаче и попадет ли она туда вообще.
Пара name и content встречается чаще других, но форм записи всего три:
| Форма | Пример | Для чего |
|
|
описание, правила индексирования, мобильный показ |
|
|
объявление кодировки документа |
|
|
замена HTTP-заголовка средствами страницы |
С третьей формой путаницы больше всего. http-equiv означает «эквивалент заголовка ответа сервера». Так на странице объявляют то, что обычно приходит в HTTP-ответе: тип документа, кодировку, перезагрузку через N секунд.
Слово пишут двумя способами: «метатеги» слитно и «мета теги» через пробел или дефис. Справка Яндекса и орфографический словарь дают слитное написание, оно и используется дальше.
Какие метатеги учитывают Яндекс и Google
Оба списка опубликованы: у Яндекса это раздел справки «Метатеги, которые учитывает Яндекс» [2], у Google раздел «Метатеги и атрибуты HTML, которые поддерживает Google» [3].
| Метатег | Яндекс | |
|
попадает в сниппет, когда описывает страницу точнее ее текста |
может использоваться в описании страницы в результатах поиска |
|
задает правила индексирования и показа страницы в выдаче |
определяет правила загрузки и индексирования страниц |
|
служит признаком того, что страница пригодна для мобильных |
адаптирует сайт под мобильные, управляет масштабом окна |
|
определяет тип документа и кодировку |
определяет тип документа и кодировку |
|
не используется вовсе |
«может влиять на соответствие страницы поисковым запросам» |
|
работает, но для переезда Google рекомендует серверный редирект 301 |
перенаправляет посетителя на другой адрес через N секунд |
|
те же правила, что в |
не поддерживается |
|
запрещает предлагать перевод страницы |
не поддерживается |
|
подтверждает права на сайт в Search Console |
не поддерживается |
|
помечает страницу как контент для взрослых для фильтра SafeSearch |
не поддерживается |
|
запрещает сервисам Google читать страницу вслух |
не поддерживается |
|
не поддерживается |
скрывает страницу из показов в теме «Услуги» |
|
не поддерживается |
скрывает страницу из показов в теме «Квартиры» |
«Не поддерживается» означает, что тег специфичен для одной системы. Другая его просто игнорирует, и вреда странице от этого нет.
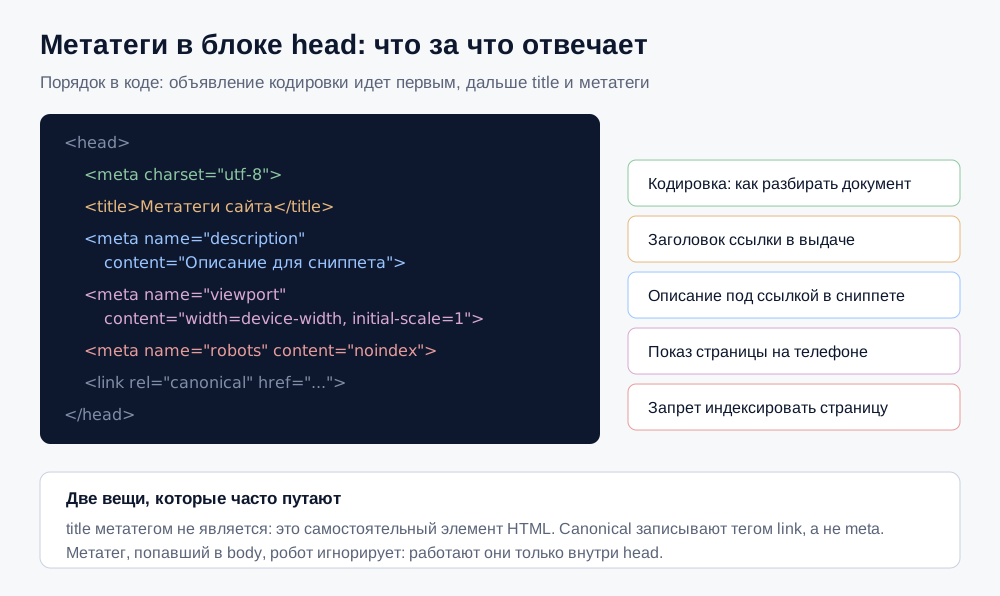 Порядок в блоке head и назначение каждой строки. Кодировка объявляется первой, canonical записывают тегом link, а не meta
Метатег description
Тег description, он же мета-описание страницы, — единственный метатег, содержимое которого поисковик может показать человеку дословно.
<meta name="description" content="Краткое описание страницы для сниппета" />Google описывает правило так: «Сниппеты создаются прежде всего из содержимого самой страницы. Однако иногда Google использует HTML-элемент meta description, если тот описывает страницу точнее, чем текст, взятый непосредственно со страницы» [1]. Яндекс формулирует осторожнее: description «может использоваться в описаниях страниц сайта в результатах поиска» [2].
Ни одна из систем показать ваш текст не обещает. Когда под запрос человека description подходит хуже, чем абзац на самой странице, поисковик покажет абзац.
Ограничения на длину тега нет, сниппет обрезается под ширину экрана устройства [1]. Режется описание по ширине в пикселях, а не по числу символов: строка из широких букв обрывается раньше, чем строка из узких той же длины. Практический ориентир 150–160 знаков: столько помещается в сниппет на десктопе. Хвост может не поместиться, поэтому главное ставят в начало строки.
Описания страниц должны различаться между собой. Одинаковый description на весь каталог поисковик не возьмет: выбрать по нему одну страницу из десяти похожих нельзя. Различаться они могут одними значениями: в каталоге описания собирают шаблоном, где общая часть у всех одна, а модель, цена и срок у каждой страницы свои.
Описание отвечает на вопрос, который человек задает перед кликом: что есть, от какой цены, с какими сроками.
Например, две версии description для страницы МРТ в медицинской клинике.
Было: «Наша клиника предлагает широкий спектр медицинских услуг. Опытные врачи, современное оборудование, индивидуальный подход к каждому пациенту».
Стало: «МРТ коленного сустава: 4 900 ₽, томограф 1,5 Тл, заключение врача за 40 минут. Клиника у метро Академическая, запись на сегодня».
Вторая строка называет цену, оборудование, срок и адрес. Под первую подходит любая клиника страны: человек в выдаче не узнает из такого описания ничего.
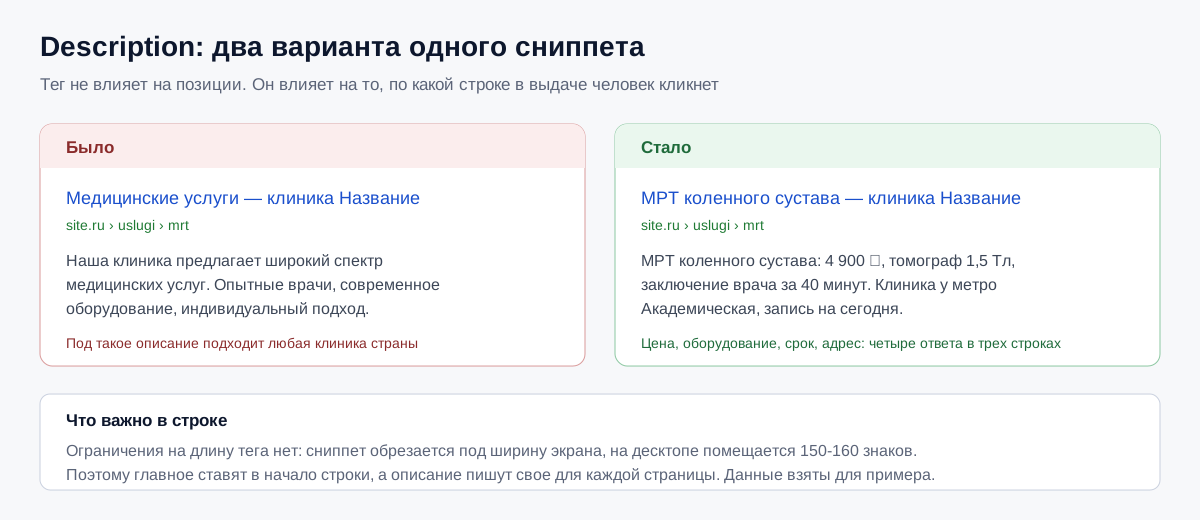 Один и тот же сниппет с общим и с конкретным описанием. Данные взяты для примера
Что ставить в описание, зависит от типа страницы. Данные в таблице взяты для примера.
| Тип страницы | Что в description | Пример начала строки |
Карточка товара или услуги |
цена, срок, условие покупки |
«МРТ коленного сустава: 4 900 ₽, заключение за 40 минут» |
Категория каталога |
сколько позиций, от какой цены, доставка |
«Lada Vesta: 14 машин в наличии от 1 490 000 ₽» |
Статья блога |
что читатель узнает и на чем это основано |
«Какие метатеги учитывают Яндекс и Google: разбор по официальным справкам» |
Главная |
чем занимается компания, где работает |
«SEO-продвижение сайтов в Москве: оплата за результат, отчет каждый месяц» |
Контакты и филиалы |
адрес, время работы, способ связи |
«Клиника на Профсоюзной: прием с 8:00 до 21:00, запись по телефону» |
На позиции description не влияет. Влияет он на другое: человек выбирает между десятью строками выдачи, и description — все, что он про вашу страницу прочитает до перехода. Чем чаще выбирают вашу строку, тем выше CTR, а он входит в поведенческие факторы. Как устроен сниппет, разобрано в статье про роль сниппетов в продвижении.
Метатег robots
Тег robots задает правила индексирования страницы: закрыть ее от поиска, запретить переходы по ссылкам, ограничить сниппет.
<meta name="robots" content="noindex, nofollow" />| Значение | Что делает | Кто учитывает |
|
не индексировать страницу, не показывать ее в выдаче |
Яндекс и Google |
|
не переходить по ссылкам на странице |
Яндекс и Google |
|
то же, что |
Яндекс и Google |
|
разрешает индексировать страницу и переходить по ссылкам |
Яндекс и Google |
|
не показывать ссылку на сохраненную копию страницы |
только Яндекс: Google относит правило к устаревшим и не учитывает [4] |
|
ограничивают длину описания и размер картинки в сниппете |
только Google |
|
убрать страницу из выдачи после указанной даты |
только Google |
Директивы из таблицы работают и в HTTP-заголовке X-Robots-Tag [4] [5]. Заголовком закрывают от индексирования файл, у которого нет HTML-кода: PDF, изображение, архив.
Противоречивые директивы системы трактуют по-разному. Google из двух конфликтующих правил применяет более строгое [4], а Яндекс берет разрешающее [5]. Один и тот же набор директив на странице даст в Google запрет, а в Яндексе разрешение, поэтому противоречия в наборе убирают до публикации.
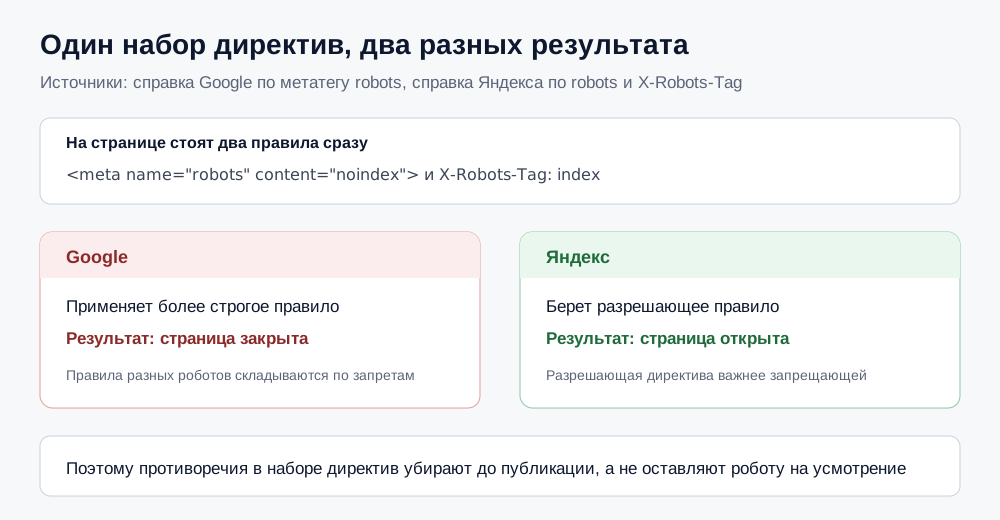 Противоречивый набор директив дает в двух системах противоположный результат
Правило noindex работает только на странице, которую робот может обойти. Страница, закрытая в robots.txt, роботу недоступна, и noindex он там не прочитает. Google описывает это прямо: если сканирование страницы запрещено файлом robots.txt, правила индексирования робот не найдет, а значит, и не выполнит [4].
Чтобы убрать из выдачи страницу, закрытую в robots.txt, сначала открывают обход и ставят noindex, ждут выпадения из выдачи и только потом закрывают обход снова, если он действительно мешает.
Часть страницы убирают из сниппета атрибутом data-nosnippet на теге <div>, <span> или <section>: сама страница остается в индексе [4]. Ставится он в теле страницы, а не в блоке <head>, и Яндекс его не поддерживает.
Метатег viewport
<meta name="viewport" content="width=device-width, initial-scale=1" />Тег viewport сообщает браузеру, как отрисовывать страницу на телефоне. Google считает его наличие признаком того, что страница пригодна для мобильных устройств [3]; Яндекс относит тег к учитываемым и описывает его как управление масштабом окна просмотра [2].
Без viewport браузер телефона рисует страницу в десктопной ширине и уменьшает ее целиком: текст становится мелким, а попасть пальцем по ссылке трудно. Google обходит сайты мобильным роботом и индексирует мобильную версию страницы, поэтому тег ставят на всех страницах сайта.
Метатег keywords в Google и Яндексе
Google. «Тег meta-keyword не используется Google Поиском, и он вообще никак не влияет на индексирование и ранжирование» [3].
Яндекс. Тег стоит в списке учитываемых с формулировкой «может влиять на соответствие страницы поисковым запросам» [2].
Заполнять keywords не запрещено, но рассчитывать на него не стоит: Google тег не читает, а Яндекс ограничился словами «может влиять». Десятки фраз в теге не дадут ничего: релевантность страницы обе системы считают по ее содержимому.
Объявление кодировки charset
<meta charset="utf-8" />Тег charset объявляет браузеру и роботу, в какой кодировке набран документ. Обе системы его учитывают [2] [3], а Google рекомендует UTF-8 [3]. При неверной кодировке вместо текста показываются нечитаемые символы, и робот получает ровно то же самое.
Ставится тег в начале блока <head>, до <title>: браузер читает первые строки документа, чтобы понять, как разбирать остальное.
Метатеги, которые не влияют на поиск
revisit-after должен был сообщать роботу, через сколько дней вернуться. В списках учитываемых тегов ни у Яндекса, ни у Google его нет [2] [3], а частоту обхода робот определяет сам.
author, copyright, generator на ранжирование не влияют. Авторство передается микроразметкой.
content-language указывает язык документа, и его часто путают с объявлением кодировки, хотя кодировку задает charset. Язык обе системы определяют по содержимому страницы: Google пишет, что языковые аннотации в коде он не учитывает [3].
refresh браузер выполняет до сих пор: по этой команде он перезагружает страницу или перенаправляет посетителя через N секунд. Как способ переезда страницы тег не годится: нужен серверный редирект 301, его же рекомендует Google [3].
noyaca запрещал Яндексу брать описание сайта из Яндекс Каталога. Каталог закрыт в 2021 году, в справке по метатегу robots директивы больше нет [5].
Все перечисленные теги до сих пор копируют в шаблоны из старых руководств, и ни один из них на обход и ранжирование не влияет.
Title, canonical, Open Graph и микроразметка
title в число метатегов не входит. Это самостоятельный HTML-элемент. В интерфейсе CMS поля title и description стоят рядом, отчего их и смешивают.
title участвует в ранжировании и становится заголовком-ссылкой в выдаче, description в ранжировании не участвует и работает на клик. Поэтому запрос ставят в title, а в description пишут то, чем страница отличается от соседних строк выдачи. Как составлять заголовок, разобрано отдельно: title и заголовок H1.
canonical указывает основную версию страницы при дублях. Записывают canonical тегом <link>, и подстановка <meta> вместо него — частая ошибка при ручной правке шаблона:
<link rel="canonical" href="https://example.ru/catalog/vesta/" />Open Graph. Теги og:title, og:description и og:image управляют тем, как ссылка выглядит при отправке в мессенджер или соцсеть. На поиск разметка не влияет, на переходы влияет: ссылка без картинки и заголовка приходит в чат голым адресом, и кликают по ней реже.
Микроразметка Schema.org отвечает за расширенные сниппеты: цену, рейтинг, хлебные крошки. Механизм у нее другой: структурированные данные размечают содержимое страницы, а не блок <head>. Разобрана она отдельно: микроразметка Schema.org.
Шаблоны description для большого каталога
Руками написать description для трех тысяч карточек не получится ни у кого, поэтому описания в каталоге собирают шаблоном с подстановкой. Качество шаблона зависит от числа переменных в нем.
Плохой шаблон выглядит так:
Купить {категория} в интернет-магазине. Низкие цены, доставка.Он дает три тысячи почти одинаковых строк, и в сниппет поисковик такие описания не берет.
Рабочий шаблон подставляет то, чем страницы каталога действительно различаются:
{Модель} {год}: {количество} в наличии от {цена} ₽.
Тест-драйв в {город}, трейд-ин, гарантия {срок}.
Например, у автодилера в Москве в наличии 14 машин Lada Vesta 2026 года, минимальная цена 1 490 000 ₽, гарантия 3 года. Шаблон дает строку:
«Lada Vesta 2026: 14 машин в наличии от 1 490 000 ₽. Тест-драйв в Москве, трейд-ин, гарантия 3 года».
Данные взяты для примера. В строке 98 знаков, у каждой модели каталога подставятся свои числа, и одинаковых описаний среди них не будет.
Описания можно и сгенерировать нейросетью, но в каталоге это дороже и хуже шаблона: нейросеть не знает ни остатков, ни цен, а придуманные ею детали человек в выдаче прочитает как обещание. На важных страницах она годится как черновик под правку, на тысячах карточек работает подстановка.
Порядок работы с шаблоном:
- Шаблон настраивается на весь каталог.
- Двадцать-тридцать самых важных страниц переписываются руками поверх шаблона.
- Раз в квартал все description выгружаются краулером и сортируются: повторы означают, что переменная не подставилась.
Выгрузка нужна из-за поломок подстановки: модель без цены или категория без остатков оставляют на месте числа пустоту или ноль.
Где заполняют метатеги в движке сайта
Руками в HTML метатеги правят только на самописных сайтах. В движке для них есть отдельные поля двух уровней: значение конкретной страницы и шаблон на весь тип страниц.
| Движок | Где поля страницы | Где шаблон |
1С-Битрикс |
вкладка «SEO» при редактировании элемента или раздела инфоблока |
настройки инфоблока, шаблоны метатегов с макросами вида |
WordPress |
поля SEO-плагина под редактором записи: Yoast, Rank Math, All in One SEO |
настройки того же плагина, шаблоны отдельно для записей, страниц и рубрик |
Правило одно на все движки: значение страницы перебивает шаблон. Шаблон закрывает каталог целиком, ручное значение — одну страницу.
Еще одна общая черта: незаполненное поле не означает пустой тег. Если у инфоблока или у типа записей задан шаблон, движок подставит его, а часть SEO-плагинов при пустом поле берет первые строки текста страницы. В коде тег после этого выглядит заполненным, и выборочный просмотр ничего не показывает: повторы видно только в общей выгрузке.
Как проверить метатеги своего сайта
- Одна страница. Ctrl+U открывает исходный код страницы, метатеги смотрят в блоке
<head>. - Глазами робота. Яндекс Вебмастер, раздел «Инструменты», дальше «Проверка ответа сервера»: там виден код ответа и HTML, который получает робот.
- Весь сайт сразу. Краулер выгружает title и description по всем страницам, повторы видно сортировкой выгрузки.
- Страницы, закрытые от индексирования. В Search Console отчет «Индексирование» показывает страницы, исключенные тегом
noindex.
Отчет по noindex смотрят после каждого обновления сайта. Правило noindex, перенесенное с тестовой версии на боевую, убирает из поиска рабочие страницы, а по трафику это заметно только через недели.
Частые ошибки в метатегах
Одинаковый description на всех страницах. Шаблон без переменных выдает одну и ту же строку, и в сниппет она не попадает.
Главное вынесено в конец description. Видимая часть сниппета обрезается под ширину экрана, и вместе с хвостом теряется то, ради чего кликают.
Ключевые слова через запятую вместо описания. Такую строку читает человек в выдаче, и кликают по ней реже.
noindex на нужной странице. Первое, что проверяют, когда страница пропала из поиска.
Метатеги в <body>. Работают они только внутри <head>. Метатег, попавший в тело страницы, робот игнорирует.
Два description на одной странице. Появляются, когда тег прописан и в шаблоне движка, и в SEO-плагине. Какой из двух возьмет поисковик, предсказать нельзя.
Ставка на keywords. Google тег не читает вовсе.
Если разбираться с этим самостоятельно некогда, техническую часть мы закрываем при SEO-продвижении сайта: метатеги входят в базовый набор работ первого месяца.
Частые вопросы
Влияют ли метатеги на позиции?
Напрямую влияет только robots: он способен убрать страницу из выдачи целиком. description влияет косвенно, через кликабельность сниппета.
Нужно ли заполнять keywords?
Google его не использует. Если решите заполнять, ограничьтесь несколькими фразами по теме страницы.
Что важнее, title или description?
title. Он влияет на ранжирование, а description на клик.
Можно ли не писать description вручную?
На больших каталогах его генерируют шаблоном с подстановкой характеристик. Для важных страниц пишут руками.
Сколько метатегов нужно странице как минимум?
Три: description, viewport и объявление кодировки charset. robots добавляют там, где страницу надо закрыть от индексирования. Остальные теги ставят по необходимости.
Зачем нужны метатеги, если на позиции они почти не влияют?
Метатеги отвечают за то, как страница показывается человеку и что робот делает с ней дальше: description собирает сниппет, robots управляет индексированием, viewport отвечает за мобильный показ, charset за читаемость текста. Позиции считаются по содержимому веб-страницы, а метатеги решают, дойдет ли это содержимое до выдачи.
Почему в выдаче показывается не мой description?
Поисковик решил, что текст со страницы отвечает на запрос лучше. Чаще всего причина в одном из четырех: описание не содержит слов запроса, оно короче двух строк, в нем стоят ключи через запятую или оно повторяется на десятках страниц. Менять в этом случае надо содержимое страницы и само описание, а не искать настройку.
Источники
- Google Search Central. Control your snippets in search results. developers.google.com/search/docs/appearance/snippet
- Яндекс Вебмастер. Справка. Метатеги, которые учитывает Яндекс. yandex.ru/support/webmaster/ru/controlling-robot/html
- Google Search Central. Meta tags and HTML attributes that Google supports. developers.google.com/search/docs/crawling-indexing/special-tags
- Google Search Central. Robots meta tag specifications. developers.google.com/search/docs/crawling-indexing/robots-meta-tag
- Яндекс Вебмастер. Справка. Метатег robots и HTTP-заголовок X-Robots-Tag. yandex.ru/support/webmaster/ru/controlling-robot/meta-robots